Research

Publications

2026

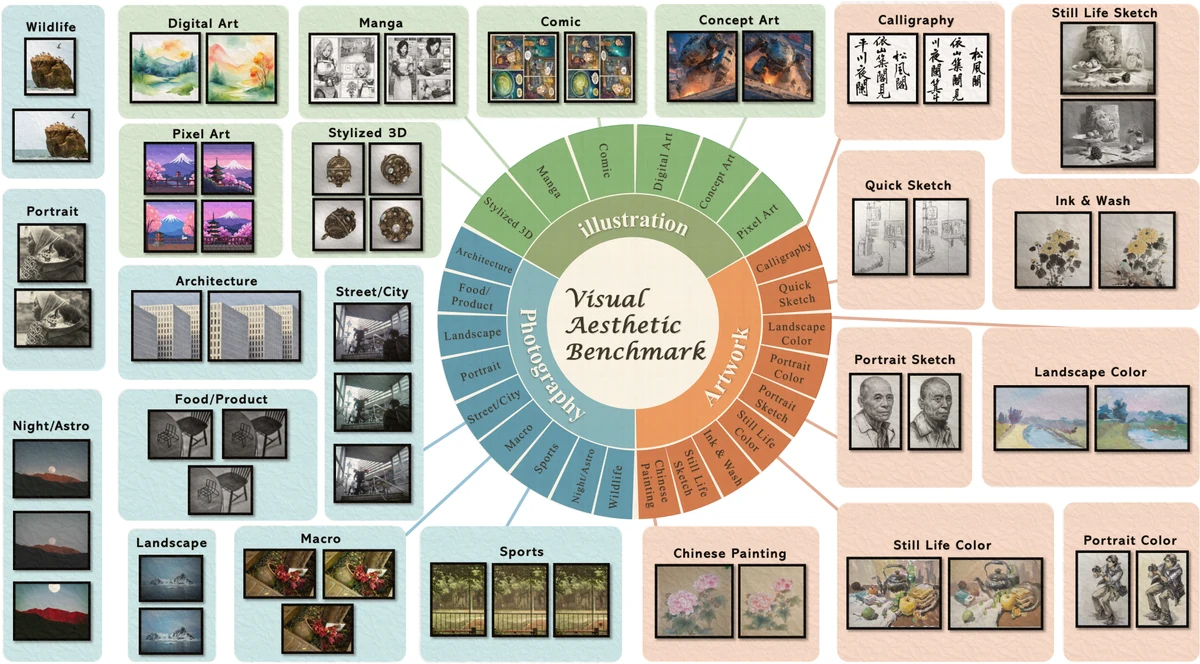
Visual aesthetic benchmark categories and comparative image examples.

COLM 2026

Visual Aesthetic Benchmark: Can Frontier Models Judge Beauty?

Yichen Feng, Yuetai Li, Chunjiang Liu, Fengqing Jiang, Yue Huang, Yuanyuan Chen, Hang Hua, Zhengqing Yuan, Kaiyuan Zheng, Luyao Niu, Bhaskar Ramasubramanian, Basel Alomair, Xiangliang Zhang, Misha Sra, Zichen Chen, Radha Poovendran, Zhangchen Xu

Introduced an expert-grounded benchmark for visual aesthetics across art, photography, and illustration, revealing a substantial gap between 20 frontier vision-language models and expert judgment.

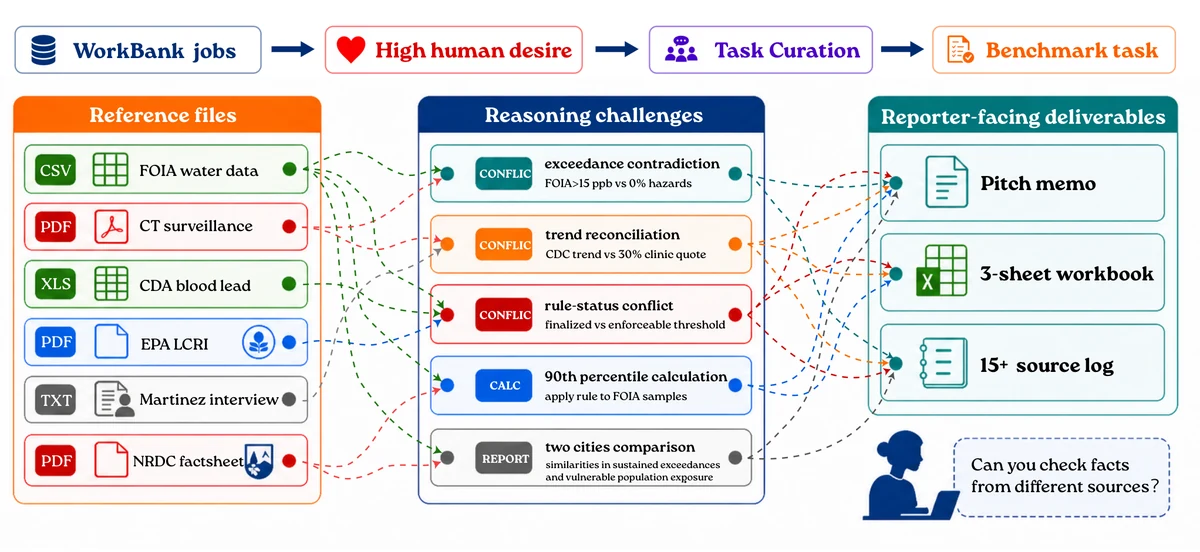
JobBench workflow linking reference files, reasoning challenges, and deliverables.

Preprint, 2026

JobBench: Aligning Agent Work With Human Will

Yuetai Li, Yichen Feng, Zhangchen Xu, Zixian Ma, Kaiyuan Zheng, Fengqing Jiang, Xinghua Sun, Rulin Shao, Zichen Chen, Yue Huang, Xinyang Han, Brian Lee, Kayla Xu, Shenglai Zeng, Hang Hua, Xiangliang Zhang, Basel Alomair, Ranjay Krishna, Luke Zettlemoyer, Pang Wei Koh, Bhaskar Ramasubramanian, Luyao Niu, Xiang Yue, Radha Poovendran

Developed a benchmark of 130 agentic tasks across 35 occupations, evaluating workflows that human experts prioritize for delegation and grading outputs with task-specific rubrics.

Adopted by Meta Muse Spark, Kimi K3, and Qwen3.8
2025

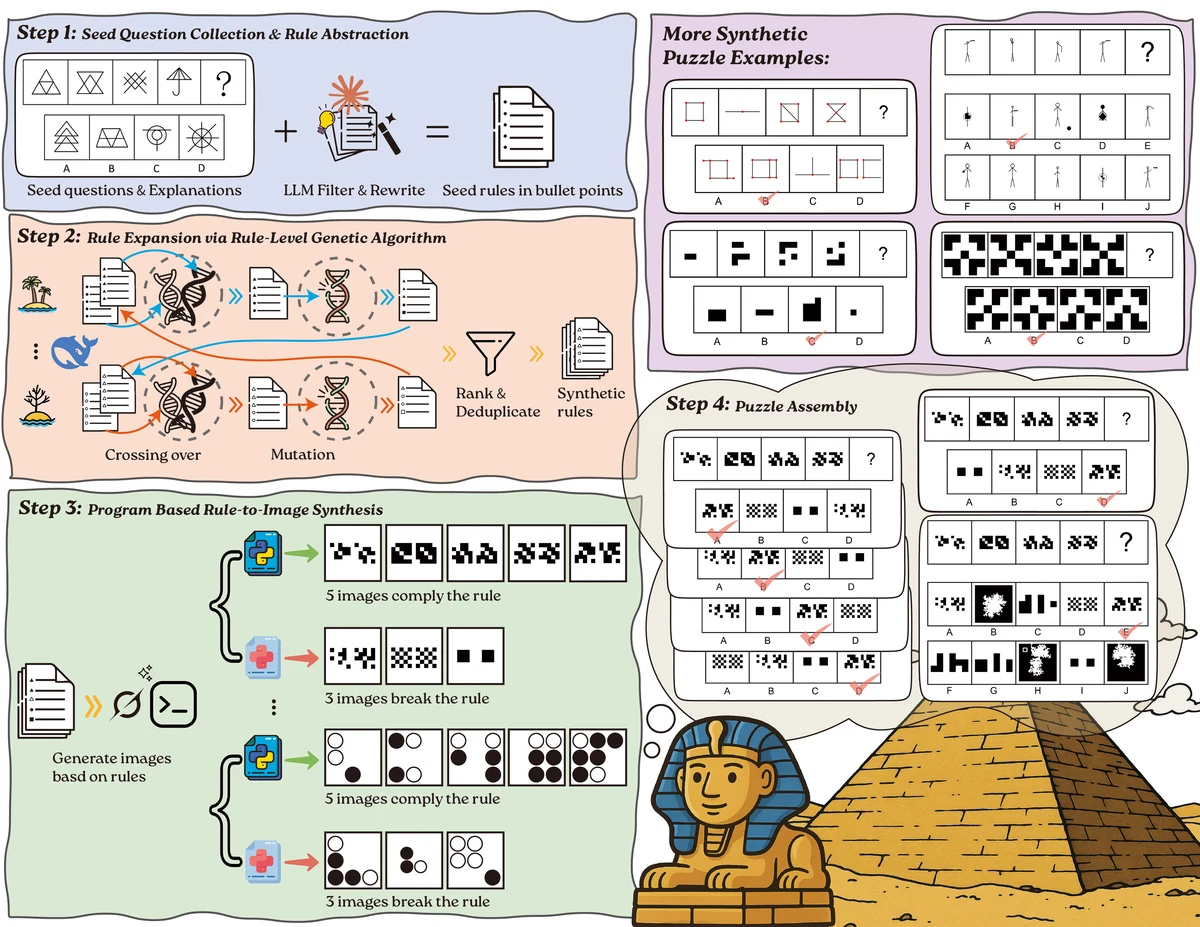
VisualSphinx synthetic puzzle generation pipeline and examples.

DataWorld Workshop at ICML 2025

VisualSphinx: Large-Scale Synthetic Vision Logic Puzzles for RL

Yichen Feng, Zhangchen Xu, Fengqing Jiang, Yuetai Li, Bhaskar Ramasubramanian, Luyao Niu, Bill Yuchen Lin, Radha Poovendran

Created large-scale synthetic visual logic puzzles using a rule-to-image pipeline. Applied reinforcement learning to improve vision-language models' logical reasoning and transfer across reasoning tasks.